

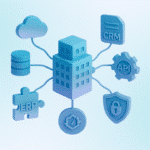
Um pipeline de dados é a sequência automatizada de etapas que move dados de onde eles nascem (sistemas, aplicativos, sensores, planilhas) até onde eles podem ser analisados, com coleta, transformação e carga acontecendo sem intervenção manual a cada execução.
Pense em um pipeline de dados como o encanamento de uma casa. A água (o dado) sai de várias fontes, passa por filtros e registros (transformação) e chega limpa e pronta para uso nas torneiras (os painéis e relatórios). Se o encanamento tem vazamento, entupimento ou conexão errada, a água que chega na torneira vem suja, atrasada ou não chega. Com dados é a mesma lógica: a diferença entre uma empresa que decide rápido e uma que decide sobre números errados normalmente não está na ferramenta de BI usada, está na qualidade da engenharia por trás do encanamento.
Como funciona um pipeline de dados na prática
Todo pipeline de dados, independentemente da ferramenta escolhida, segue três movimentos centrais.
Coleta (extração)
Os dados são extraídos das fontes de origem: ERP, CRM, planilhas, bancos transacionais, APIs de terceiros, sensores de IoT. Nessa etapa, o pipeline precisa lidar com formatos diferentes, volumes variáveis e, principalmente, com mudanças na estrutura da fonte (uma coluna renomeada no sistema de origem não pode quebrar o pipeline inteiro).
Transformação
Os dados brutos são limpos, padronizados, enriquecidos e agregados para fazer sentido juntos. É aqui que nomes de clientes duplicados são unificados, moedas são convertidas para um padrão único e regras de negócio (como definição de “cliente ativo”) são aplicadas de forma consistente.
Carga
Os dados tratados são carregados no destino final, normalmente um data warehouse ou um data lake, de onde ferramentas de BI, modelos de machine learning ou times de análise passam a consumir a informação já confiável.
Sobre esse fluxo, ainda somam-se dois elementos que separam um pipeline profissional de um script improvisado: monitoramento (alertas quando algo falha ou atrasa) e governança (quem pode acessar o quê, e com que nível de qualidade garantido).
Pipeline de dados vs. integração manual: qual a diferença
Muita empresa já faz “integração de dados” sem pipeline, só que na mão: alguém exporta um CSV, ajusta fórmulas no Excel, cola em outra planilha e sobe para o painel. Funciona, até certo volume e até a pessoa que sabe fazer isso sair de férias ou da empresa.
A diferença prática entre pipeline de dados e integração manual está em três pontos:
- Repetibilidade. O pipeline roda igual, todo dia, sem depender de alguém lembrar de rodar a planilha.
- Rastreabilidade. Se um número está errado, dá para checar em qual etapa do pipeline o problema entrou. Numa cadeia de planilhas, isso costuma ser arqueologia.
- Escala. Integração manual quebra quando o volume de dados ou o número de fontes cresce. Pipeline de dados foi desenhado para crescer junto com a empresa.
Isso não significa que planilha seja inimiga. Planilha continua ótima para análise pontual. O problema é usá-la como a espinha dorsal do fluxo de dados recorrente de uma empresa que já cresceu.
Tipos de pipeline de dados
Pipeline em batch (lote)
O pipeline em batch processa os dados em blocos, em intervalos definidos (de hora em hora, uma vez por dia, uma vez por semana). É o modelo mais comum e mais barato de operar, ideal quando a decisão de negócio não depende de saber o que aconteceu nos últimos segundos, como fechamento financeiro mensal ou relatório de vendas do dia anterior.
Pipeline em tempo real (streaming)
O pipeline em tempo real processa cada evento de dado assim que ele acontece, com latência de segundos. É o modelo usado para detecção de fraude, monitoramento de operação crítica ou personalização de oferta no momento da navegação do cliente. Mais de 60% das empresas já implementam algum pipeline de dados em tempo real para inteligência operacional, segundo levantamento da Integrate.io, reflexo da pressão por decisão mais rápida.
Na prática, a maioria das empresas não escolhe um ou outro: usa batch para o grosso dos relatórios gerenciais e reserva tempo real para os poucos processos em que segundos realmente importam. Tentar rodar tudo em tempo real sem necessidade só encarece a operação sem ganho real de decisão.


Ferramentas de pipeline de dados no mercado
O mercado de ferramentas de pipeline de dados foi avaliado em mais de US$ 12 bilhões em 2025, com crescimento projetado acima de 20% ao ano até o fim da década, segundo a Grand View Research. Isso mostra que o tema deixou de ser “coisa de time de TI grande” e virou infraestrutura básica de qualquer empresa orientada a dados.
Hoje, um pipeline de dados moderno costuma combinar ferramentas especializadas em cada etapa, em vez de uma única ferramenta que tenta fazer tudo:
- Ingestão: Fivetran, Airbyte e conectores nativos de cada nuvem.
- Orquestração: Apache Airflow segue como a ferramenta mais usada para organizar dependências e horários de execução entre etapas do pipeline.
- Transformação: dbt lidera a transformação de dados já dentro do data warehouse, com testes automatizados e documentação da linhagem do dado.
- Nativas de nuvem: Azure Data Factory, AWS Glue e Google Cloud Dataflow, quando a empresa já opera dentro de um provedor de nuvem específico.
Nenhuma dessas ferramentas substitui a outra: elas resolvem partes diferentes do mesmo pipeline. Ferramenta certa sem modelagem de dados correta por trás continua entregando número errado, só que mais rápido.
5 sinais de que sua empresa precisa de um pipeline de dados
- Relatórios importantes dependem de alguém copiar e colar dados manualmente todo mês.
- Dois times apresentam números diferentes para o mesmo indicador, porque cada um “trata” o dado do seu jeito.
- A empresa já tem mais de 3 ou 4 fontes de dados relevantes (ERP, CRM, e-commerce, planilhas) que precisam conversar entre si.
- Erros só são descobertos quando o número já chegou errado na reunião de diretoria, sem forma clara de rastrear onde a falha aconteceu.
- Projetos de BI ou de IA estão parados porque “os dados não estão prontos”, mesmo depois de meses de tentativa.
Se dois ou mais desses pontos são realidade na sua empresa, o custo de continuar sem um pipeline estruturado já é maior do que o custo de construir um.
Como a beAnalytic constrói pipelines de dados (mini case)
Um exemplo real: o maior aplicativo de delivery de botijão de gás do Brasil, presente em SP, MG, RS, PR e SC, operava um ambiente multicloud complexo e enfrentava instabilidades recorrentes na área de Business Intelligence, gerando prejuízo estimado de R$ 5 mil por dia, além de dificuldade para reter conhecimento técnico de Cloud e ETL por causa do turnover da equipe.
A beAnalytic assumiu a engenharia de dados do projeto: construiu pipelines e alertas de monitoramento para as instabilidades de Cloud, automatizou o fluxo de extração, tratamento e carga (ETL) dos dados de campanhas de marketing, e centralizou a gestão dessas campanhas em uma única plataforma. O resultado foi uma redução de 40% no custo com Cloud na área de BI, eliminando os prejuízos diários causados pelas instabilidades (case completo).
É esse o tipo de ganho que um pipeline bem desenhado entrega: não é só “ter dado automatizado”, é eliminar o prejuízo escondido em instabilidade e retrabalho que ninguém está medindo.
Conclusão
Pipeline de dados não é luxo de empresa de tecnologia. É a estrutura que decide se a sua empresa vai analisar dados confiáveis ou vai continuar apagando incêndio com números que chegam atrasados, incompletos ou divergentes entre áreas. A pergunta não é se vale a pena construir um pipeline, é quanto tempo e dinheiro a operação já está perdendo por não ter um.
Se a sua empresa reconheceu algum dos sinais acima, a consultoria e outsourcing de engenharia de dados da beAnalytic ajuda a diagnosticar, desenhar e manter pipelines confiáveis, do zero ou a partir do que já existe. Fale com um especialista e descubra o primeiro pipeline que destrava decisão na sua empresa.
Perguntas frequentes
O que é um pipeline de dados em palavras simples?
É o caminho automatizado que os dados percorrem desde a origem (sistemas, planilhas, sensores) até estarem limpos e prontos para análise, sem depender de alguém mover ou tratar essa informação manualmente.
Qual a diferença entre pipeline de dados e ETL?
ETL (Extract, Transform, Load) é um dos modelos possíveis de pipeline de dados, no qual a transformação acontece antes da carga no destino. Pipeline de dados é o conceito mais amplo, que também inclui o modelo ELT e fluxos em tempo real.
Toda empresa precisa de pipeline de dados?
Precisa quando o volume de fontes e de dados já não cabe mais em planilha, ou quando divergência de números entre áreas virou rotina. Empresas menores costumam começar com um pipeline simples e crescer aos poucos.
Pipeline de dados em batch ou em tempo real: qual escolher?
Depende da decisão que o dado sustenta. Se a decisão pode esperar horas (relatório gerencial, fechamento financeiro), batch é mais barato e suficiente. Se a decisão precisa de segundos (fraude, operação crítica), vale o investimento em tempo real.
Quanto tempo leva para implementar um pipeline de dados?
Um primeiro pipeline funcional, cobrindo uma ou duas fontes prioritárias, costuma ficar pronto em poucas semanas. O prazo total depende do número de fontes, da qualidade dos dados de origem e do nível de automação e governança exigido.

Gabriela Melo é estrategista de conteúdo na beAnalytic, especializada em SEO e GEO. Com foco na criação de conteúdos otimizados para posicionar temas de Business Intelligence e Engenharia de Dados.
- Gabriela Melo

- Gabriela Melo
- Gabriela Melo
- Gabriela Melo